O Grok 4.7, lançado em 21 de setembro de 2026, não assume a liderança do Intelligence Index. Faz algo mais útil para um time que já tem um modelo de fronteira no workspace: chega perto no trabalho que os agentes de fato fazem, pelo preço do Grok 4.6. A fatura muda mesmo assim, porque o modelo gasta bem mais tokens para chegar lá.
Por que isso importa para quem usa a Tess
Um texto de benchmark é fácil de ler como ranking. A decisão na Tess é mais estreita. Astra, Fable, Sol e Grok já podem estar no mesmo workspace, no mesmo agente, sobre os mesmos documentos. O Grok 4.7 ganha lugar quando a tarefa é longa, o resultado é uma análise ou uma mudança de código, e uma pessoa revisa o que sai. É um padrão fraco quando alguém espera uma resposta curta no chat, ou quando a última milha é uma apresentação que o cliente vai ver sem retoque.
A Artificial Analysis mediu o modelo no esforço xhigh. A tabela de lançamento da xAI é um segundo retrato, de harnesses diferentes. Leia os dois juntos. Não faça a média.
Preço: a tabela não mudou, a tarefa mudou
O preço de tabela segue o do Grok 4.6: US$ 2 por milhão de tokens de entrada e US$ 6 por milhão de tokens de saída. A leitura de cache continua em US$ 0,50 por milhão, um desconto de 75%. A xAI também vende uma variante rápida, com o dobro da velocidade de saída e o dobro do preço.
Esse adesivo é o número errado para orçar. No Intelligence Index, o Grok 4.7 (xhigh) usa cerca de 81.000 tokens de saída por tarefa, contra cerca de 38.000 do Grok 4.6 (xhigh). A US$ 6 por milhão, só a saída vai de cerca de US$ 0,23 por tarefa para cerca de US$ 0,49. O mesmo contrato, cerca do dobro da conta de saída, antes de entrada, cache, ferramentas e novas tentativas.
Coloque isso ao lado do GPT-6 Astra. A tarifa publicada de saída do Astra é US$ 50 por milhão, e a Artificial Analysis o mediu em cerca de 27.000 tokens de saída por tarefa de inteligência, ou cerca de US$ 1,35 de saída. O Grok usa cerca de três vezes os tokens e ainda fica perto de um terço da conta de saída do Astra, porque o preço por token é bem mais baixo. A diferença de tokens come parte do desconto. Uma parte grande permanece.
A página do modelo coloca o custo completo de uma tarefa do Intelligence Index em US$ 3,74, com entrada e cache inclusos. Rodar o índice inteiro custou US$ 4.967, em 240 milhões de tokens de saída. Modelos verbosos ficam caros em volume mesmo quando a tabela de preços parece amigável.
Em resumo: contra o Grok 4.6, você paga mais por tarefa por um ganho pequeno de inteligência e um ganho real no trabalho de agente. Contra os modelos de fronteira a US$ 10 / US$ 50, o Grok 4.7 ainda é o caminho mais barato para chegar perto, e não é o caminho para passar deles.
Destaques do Coding Agent Index
➤ Perto o bastante para o preço passar a importar
Com o Grok Build, o Grok 4.7 (xhigh) marca 56 no Coding Agent Index, acima dos 47 do Grok 4.6 (xhigh). Fica em quarto entre os modelos nos próprios harnesses. Claude Fable 5.1 e GPT-6 Astra lideram com 62. O Claude Opus 5 fica em 60. O GPT-5.6 Sol (max), no Codex, fica em 55.
Seis pontos atrás dos líderes é uma distância real. Não é outro esporte. Para um time que roda muitas tarefas de agente por dia, esses seis pontos precisam valer a tarifa de US$ 10 / US$ 50 do Fable contra os US$ 2 / US$ 6 do Grok. No volume, muitas vezes não valem. O índice é motivo para pilotar o Grok. Não é motivo para aposentar o modelo em que você já confia nos repositórios mais difíceis.
➤ A média esconde o trabalho em que ele vai mal
O salto de nove pontos se espalha por três testes, e eles não contam a mesma história. No Grok Build, o DeepSWE v1.1 sobe de 65% para 73% e lidera o gráfico publicado, logo à frente do GPT-5.6 Sol e do Muse Spark 1.3, em 72%. O SWE-Atlas-QnA sobe de 58% para 63%. O Terminal-Bench 4.0 sobe de 18% para 33%.
Esse último número é o que merece atenção. 33% é uma melhora grande sobre o Grok 4.6 e fica longe do Fable 5.1 (58%), do GPT-6 Astra (56%) e do Opus 5 (55%) no mesmo gráfico. Um agente de código que sobretudo implementa sobre um repositório pode usar o Grok 4.7. Um agente de código que vive no terminal, lê a saída dos comandos e precisa fechar a sessão sozinho ainda tem uma ferramenta melhor no topo desse gráfico.
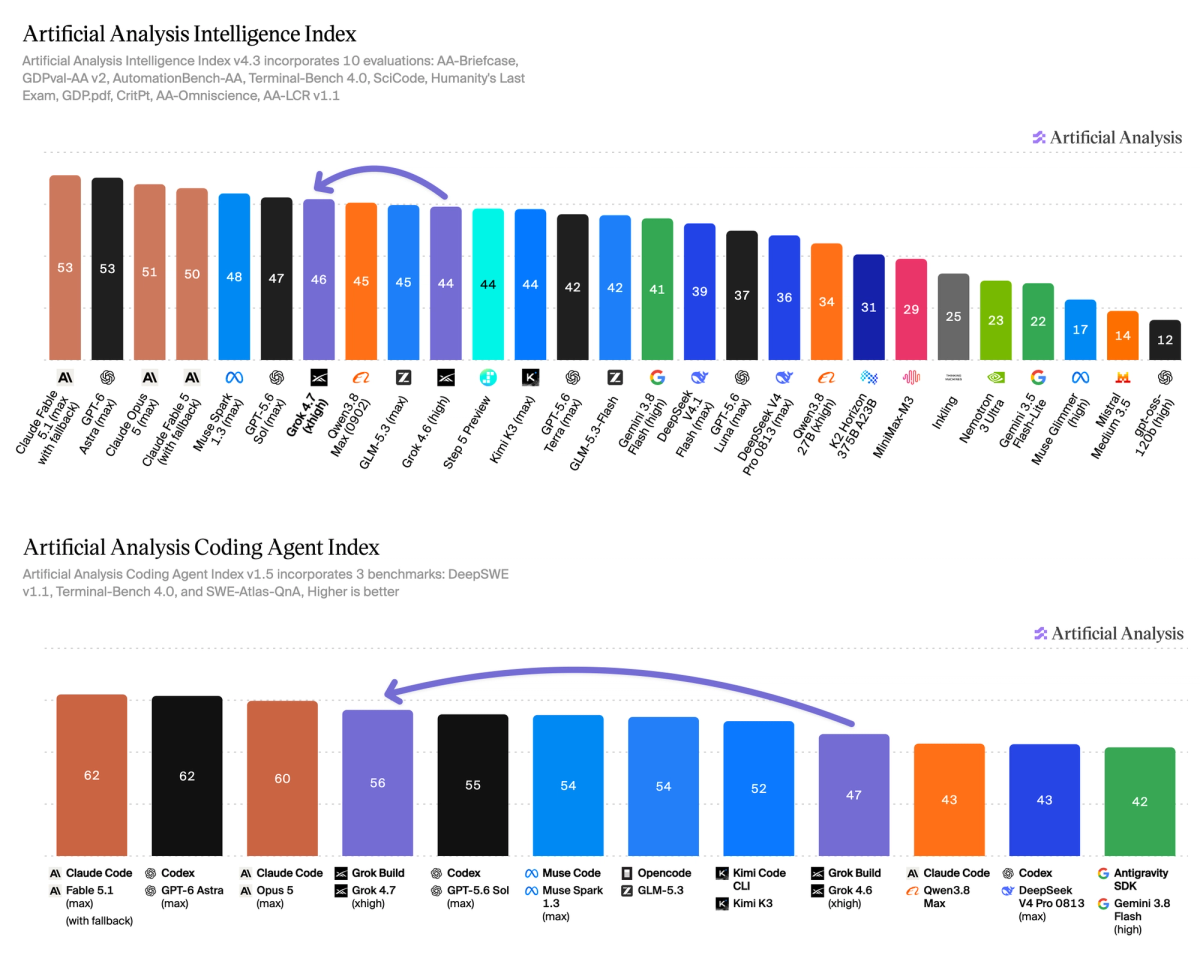
Fonte: Artificial Analysis — Intelligence Index e Coding Agent Index
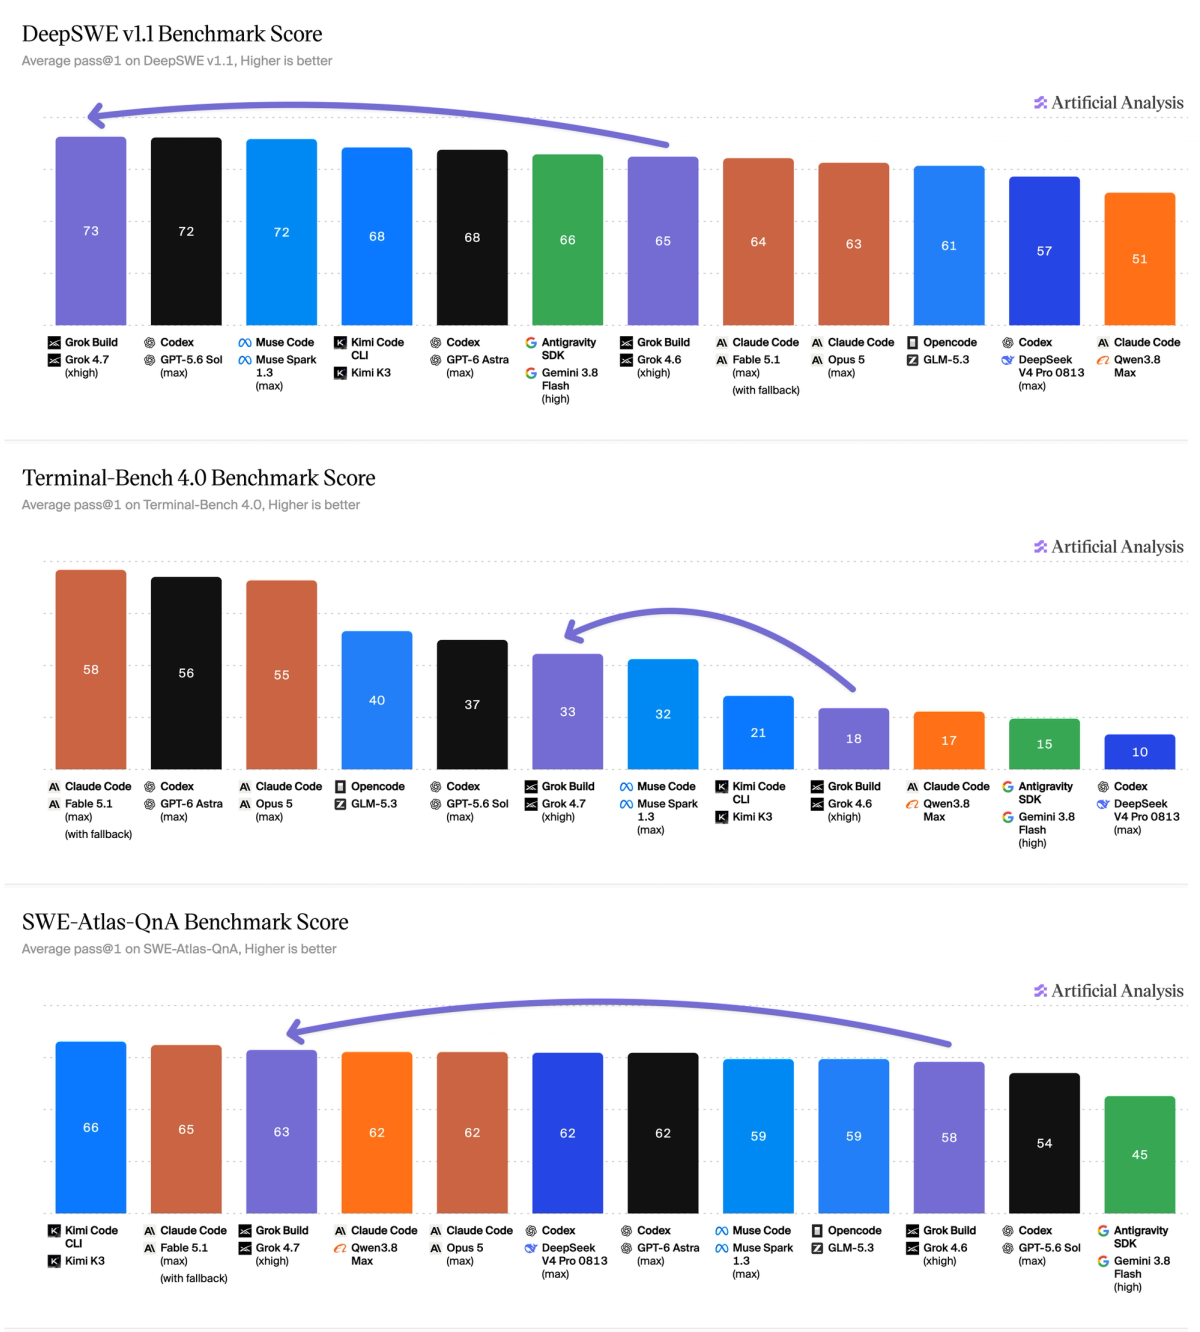
Fonte: Artificial Analysis — DeepSWE, Terminal-Bench e SWE-Atlas-QnA no Grok Build
Essas notas usam o Grok Build. O Intelligence Index abaixo usa um harness compartilhado para todos os modelos. Um ganho num deles não se transfere para o outro.
Destaques do Intelligence Index
➤ A nota de capa é a menos interessante
O Grok 4.7 (xhigh) marca 46. O Grok 4.6 (xhigh) marca 44. No mesmo gráfico, o GPT-5.6 Sol (max) fica em 47, o Muse Spark 1.3 (max) em 48, e o Fable 5.1 e o GPT-6 Astra em 53. A página do modelo o coloca em 16º entre 202 modelos da classe, bem acima de uma mediana de 24, e bem longe dos modelos que um time chamaria de fronteira.
Dois pontos são uma atualização, não uma migração. Se a única coisa de que você precisava era "um modelo geral mais inteligente", fique onde está. O caso do Grok 4.7 está nas fatias debaixo dessa média.
➤ O trabalho de conhecimento é onde "perto da fronteira" é de fato verdade
No AA-Briefcase, trabalho profissional longo com tarefas encadeadas e um conjunto grande de arquivos, o Grok 4.7 marca 1.657 Elo. São 111 acima do Grok 4.6 (high), em 1.546, logo atrás do Fable 5.1 (1.678) e do Opus 5 (1.673), e à frente do GPT-6 Astra (1.569). No GDPval-AA, documentos, planilhas e slides tirados de ocupações reais, ele marca 1.695, 90 acima de 1.605. O Fable ainda lidera, em 1.735.
A divisão de qualidade importa mais que o Elo. A qualidade analítica salta de 1.690 para 1.994. A qualidade de apresentação escorrega de 1.519 para 1.499. O modelo ficou melhor no raciocínio e não ficou melhor no artefato. Use-o para testar uma análise, reconciliar um briefing longo ou rascunhar a substância de um memorando. Ponha uma passagem de revisão, ou outro modelo, em qualquer coisa que um cliente vá julgar pela aparência.
➤ Você paga em tokens, não numa espera muito maior
Cerca de 81.000 tokens de saída por tarefa se dividem em cerca de 22.000 tokens de resposta e 59.000 tokens de raciocínio. A maior parte do gasto novo é o modelo pensando, não o modelo falando. A Artificial Analysis coloca isso em 125% mais saída que o Grok 4.6 (high), em 36.000, e 196% mais que o Astra, em 27.000.
A surpresa é o relógio. O tempo de decodificação fica em cerca de 7,1 minutos por tarefa de inteligência, ao lado de 6,6 minutos tanto para o Astra (max) quanto para o Grok 4.6 (high). Esse número exclui o tempo até o primeiro token. Neste teste, o triplo de tokens não significa o triplo de espera, porque a vazão da resposta em prompts longos fica em cerca de 188 tokens por segundo.
O uso interativo é outro teste. A página do modelo mede 38,8 tokens de saída por segundo e coloca o Grok 4.7 em 154º de 202 em velocidade, com 0,85 segundo até o primeiro token. Um agente que sai e volta com uma análise não vai sentir os 38,8. Uma pessoa olhando a bolha do chat vai.
➤ A factualidade melhorou um pouco
No AA-Omniscience, a taxa de alucinação cai de 34% no Grok 4.6 (high) para 29%. A acurácia fica estável, 47% contra 48%. O índice vai de 30 para 32. É um modelo mais limpo, não um modelo cuidadoso. Não é o tipo de queda que, sozinha, justifica trocar um fluxo sensível a fatos. A revisão continua no circuito.
➤ O resto do índice empata
No harness compartilhado, contra o Grok 4.6 (high), o Terminal-Bench 4.0 sobe 4,5 pontos e o GDP.pdf sobe 3,0. O AA-LCR cai 3,7 e o AutomationBench-AA cai 1,1. Segure esse Terminal-Bench ao lado do salto de 18% para 33% dentro do Grok Build. O mesmo nome, outro teste, outra história. Citar qualquer um dos números sozinho vai enganar um plano de rollout.
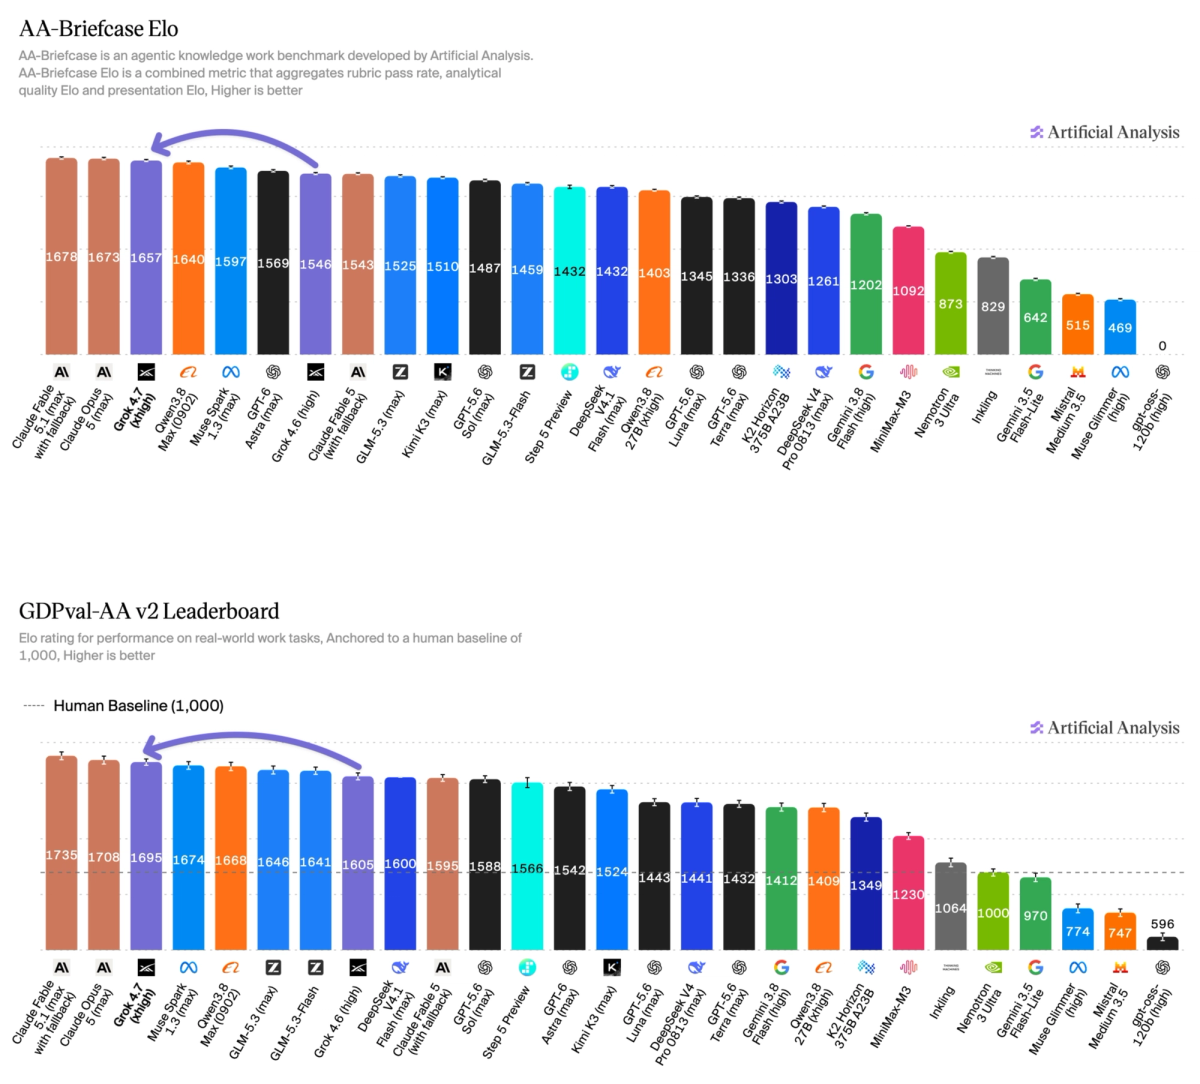
Fonte: Artificial Analysis — AA-Briefcase e GDPval-AA v2
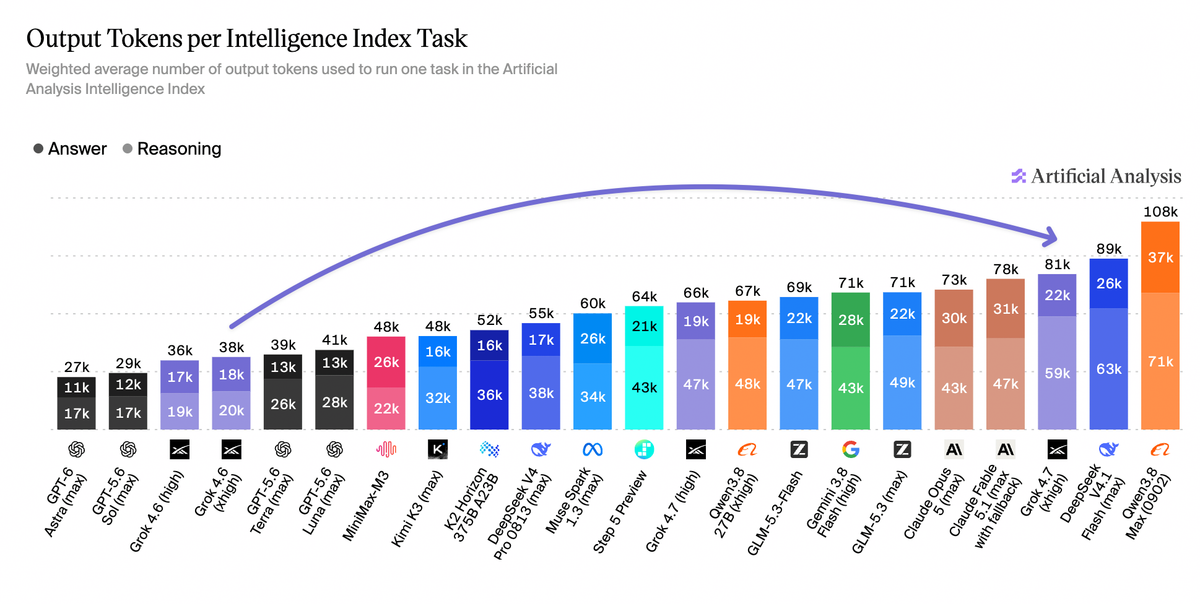
Fonte: Artificial Analysis — tokens de saída por tarefa do Intelligence Index
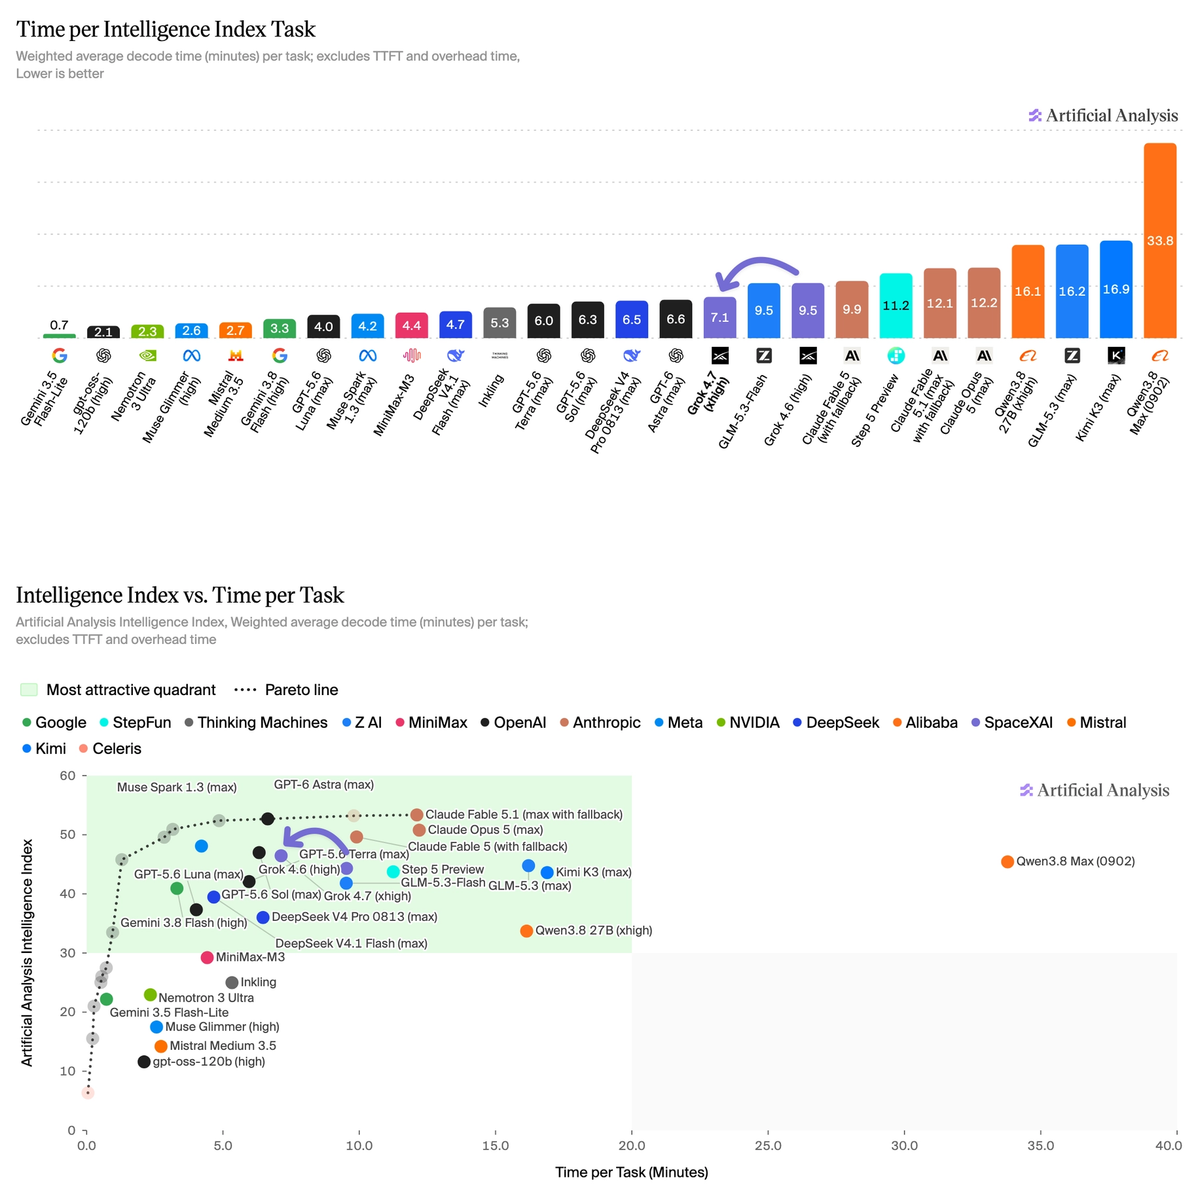
Fonte: Artificial Analysis — tempo por tarefa do Intelligence Index
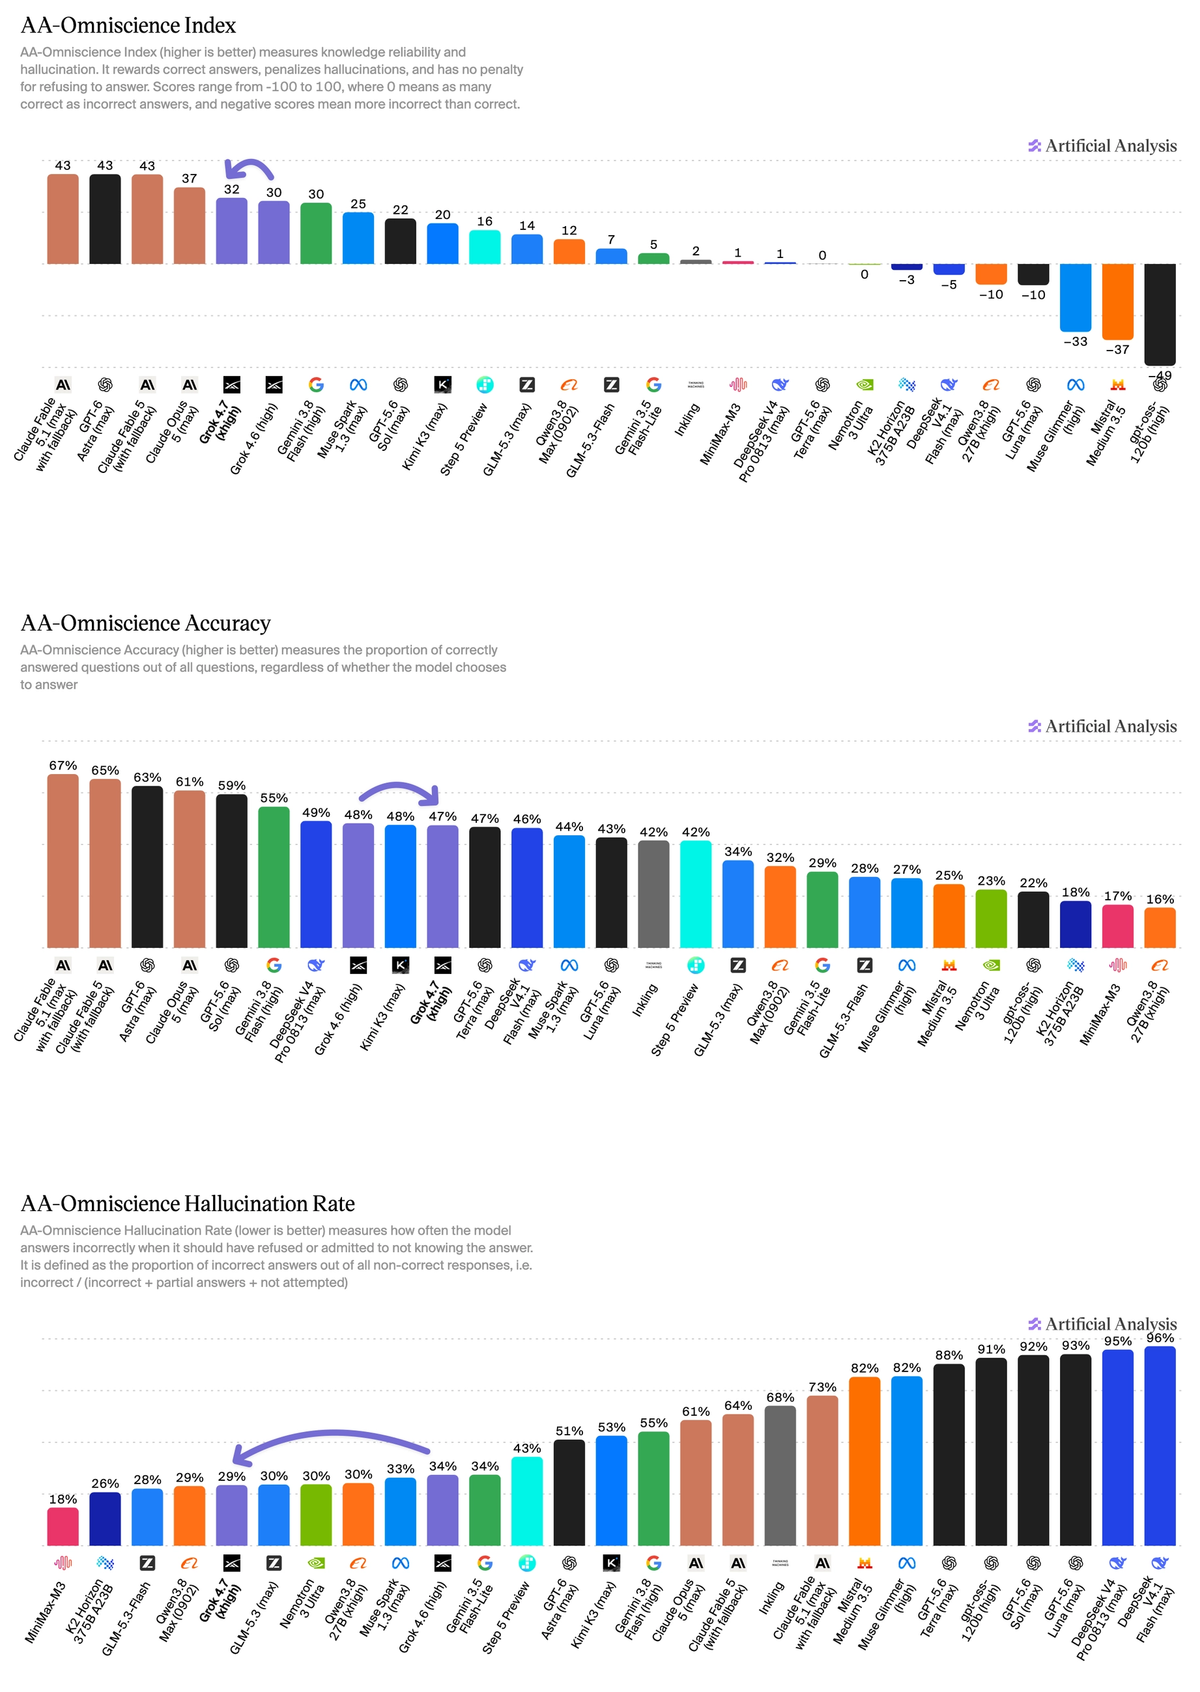
Fonte: Artificial Analysis — AA-Omniscience
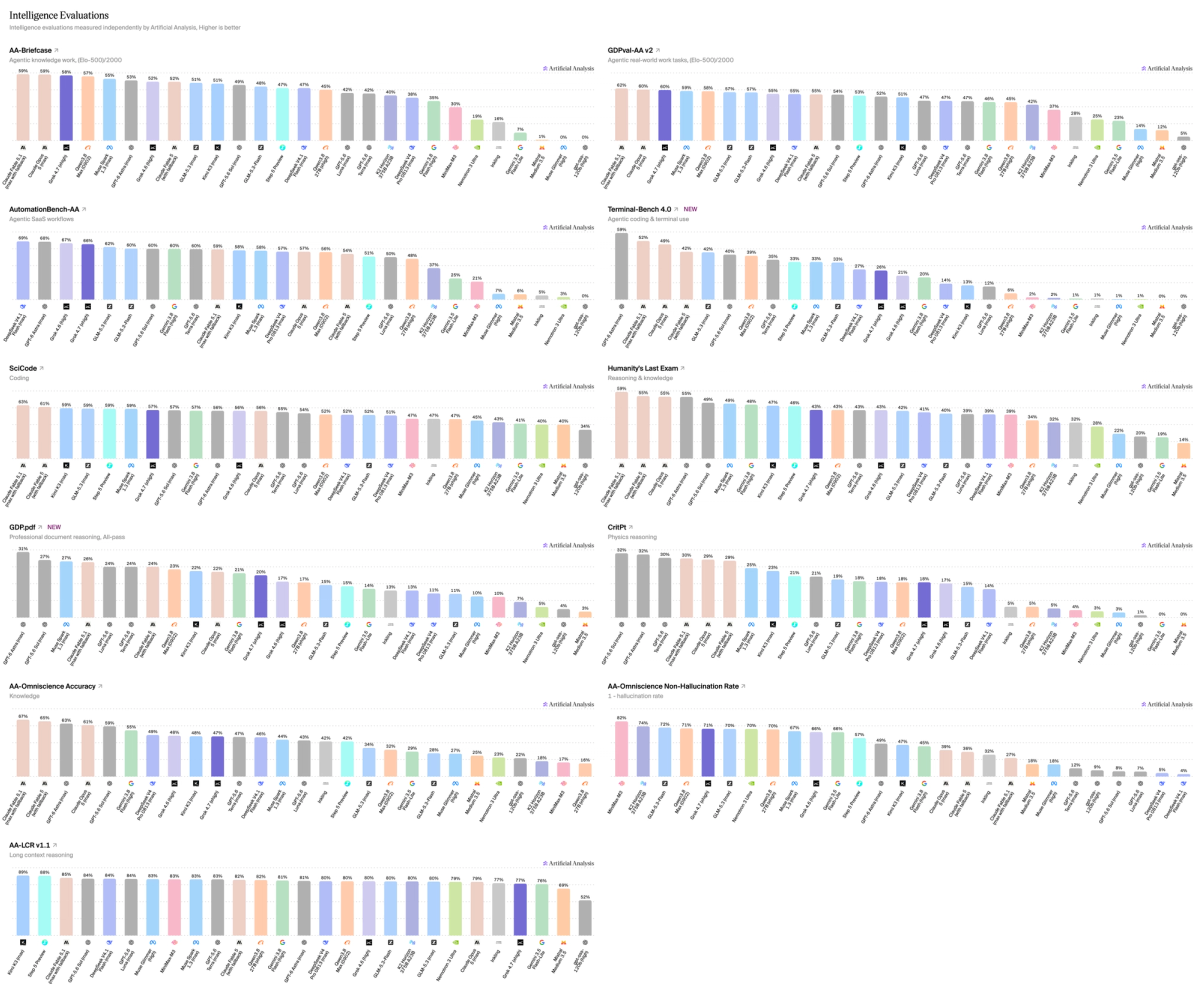
Fonte: Artificial Analysis — detalhamento das avaliações do Intelligence Index
O que a xAI reporta, e como pesar
O post de lançamento da xAI é o argumento da empresa: trabalho mais longo, mais autoverificação, o mesmo preço e a mesma velocidade do Grok 4.6. A tabela abaixo compara o Grok 4.7 (xHigh) com o Grok 4.6 (High), o GPT-5.6 Sol (Max) e o Fable 5.1 (Max). Trate-a como uma hipótese a testar, não como um segundo Intelligence Index.
A linha que conversa com a história independente de código é o CursorBench. A xAI coloca o Grok 4.7 (xHigh) em 46,3% e cerca de US$ 6,01 por tarefa, contra 41,7% e US$ 8,23 do Sol (Max), e 51,8% e US$ 17,28 do Fable (Max). Um esforço mais baixo é um controle de verdade, não uma nota de rodapé: High fica em 43,9% a US$ 4,69, Medium em 41,6% a US$ 3,49, Low em 33,1% a US$ 1,58. Se o agente não precisa do ajuste de topo, a conta cai mais rápido que a nota.
As linhas que pedem cuidado são as de especialista. O EEBench, em 64%, lidera os quatro modelos que a xAI escolheu mostrar, e o benchmark jurídico da Harvey, em 19,6%, é várias vezes o Sol (2,5%) e o Fable (6,7%). São motivos para rodar um piloto de domínio nos seus próprios casos. Não são uma certificação. 19,6% ainda é uma taxa absoluta de aprovação baixa. O HealthBench Professional, em 56,7%, vai no sentido contrário e fica atrás do Sol e do Fable. Um modelo com um pico jurídico e uma nota clínica mais fraca é candidato a especialista, não um upgrade geral.
Uma armadilha de nome fica em aberto. O Terminal-Bench 4.0 é 38,0% na tabela da xAI, 33% na rodada da Artificial Analysis no Grok Build, e só 4,5 pontos acima do Grok 4.6 no harness compartilhado. Quem compara "Terminal-Bench" entre essas páginas sem o harness na frase está comparando provas diferentes.
| Benchmark | Grok 4.7 | Grok 4.6 | GPT-5.6 Sol | Fable 5.1 |
|---|---|---|---|---|
| Entrada / saída, US$ por milhão de tokens | US$ 2 / US$ 6 | US$ 2 / US$ 6 | US$ 4 / US$ 20 | US$ 10 / US$ 50 |
| CursorBench 4.0 | 46,3% | 40,4% | 41,7% | 51,8% |
| DeepSWE v1.1 | 71,0%* | 65,2% | 72,7% | 70,0% |
| EEBench | 64,0% | 53,0% | 39,4% | 56,4% |
| AA Briefcase v1.1 | 1.657 | 1.546 | 1.487 | 1.678 |
| Terminal-Bench 4.0 | 38,0% | 20,3% | 37,3% | 57,9% |
| Harvey Legal Agent Benchmark | 19,6% | 15,8% | 2,5% | 6,7% |
| HealthBench Professional | 56,7% | 48,5% | 60,5% | 62,1% |
* A xAI marca o resultado de DeepSWE do Grok 4.7 como esforço high.
A janela de contexto é de 500.000 tokens, com entrada de texto e imagem e saída de texto. A xAI também diz que o modelo lidera os próprios testes de segurança, incluindo 62,4% no benchmark de biossegurança da LatchBio e 3,3% de passagem de prompts arriscados no HackerBench v0.3. São medições da xAI sobre testes da xAI. Para um uso sensível, são um ponto de partida para revisão, junto da sua própria política de acesso.
Na prática
- Para agentes de código pesados em repositório: pilote o Grok 4.7 no xhigh. O Coding Agent Index e o DeepSWE são onde o preço parece racional. Mantenha um modelo de fronteira nas sessões longas de terminal.
- Para análise, briefings longos e trabalho de conhecimento em várias etapas: este é o caso independente mais forte. A qualidade analítica entrou na faixa de fronteira. Não publique os slides nem o entregável formatado sem uma passagem de revisão.
- Para uma troca geral saindo de Astra, Fable ou Sol: o Intelligence Index não sustenta. Dois pontos, com uma contagem de tokens bem maior, é uma troca lateral.
- Para o orçamento: espere cerca do dobro do gasto de saída do Grok 4.6 nas tarefas difíceis, e ainda uma conta de saída menor que a do Astra no mesmo índice. Baixe o esforço para high ou medium quando a tarefa permitir. A curva do CursorBench mostra a nota caindo mais devagar que o custo.
- Para um chat que precisa parecer instantâneo: os 38,8 tokens por segundo da página do modelo são o relógio que importa. Use a variante rápida só se essa latência valer o dobro do preço.
- Para fatos, trabalho jurídico ou clínico: as alucinações caíram, não desabaram. Harvey e EEBench valem uma avaliação privada nos seus próprios arquivos. Não são motivo para pular a revisão.
A comparação que decide é uma fatia do seu próprio trabalho: um repositório, um briefing longo, uma apresentação, rodados no Grok 4.7 e no modelo que você usa hoje. A Tess foi feita para esse teste. Vários modelos, um workspace, a mesma tarefa.
Gráficos e metodologia originais: Artificial Analysis — “Benchmarking Grok 4.7”, publicado em 21 de setembro de 2026. Perfil de operação: Artificial Analysis — Grok 4.7 (xhigh). Notas reportadas pela empresa: xAI — “Introducing Grok 4.7”. Os custos de saída neste artigo usam essas contagens e esses preços de token publicados, e cobrem só os tokens de saída.